مركز برامج باردوس أم برنامج الحماية المتقدمة؟ اختيار الأداة المناسبة
قارن بين مركز برامج Pardus وأوامر APT للعثور على الحزم وتثبيتها وإزالتها وتحديثها باستخدام الطريقة التي تناسب مهمتك.
لا يعتمد الجيل القادم من أجهزة الذكاء الاصطناعي والحوسبة الفائقة على إنجاز واحد، بل يُبنى على عدة تقنيات تعمل بتناغم: ترانزستورات ذات بوابة محيطية، وتوصيل الطاقة من الجهة الخلفية، وبنى الرقاقات الصغيرة، والتغليف المتقدم، وذاكرة عالية النطاق الترددي، ووصلات أسرع بين الرقاقات، وشبكات بصرية متزايدة الانتشار. والنتيجة العملية هي قدرة حوسبة أكبر، ونطاق ترددي أوسع للذاكرة، وقابلية توسع أفضل دون الاعتماد فقط على أبعاد ترانزستور أصغر.
هذا الأمر بالغ الأهمية لأن مُسرّعات الذكاء الاصطناعي الحديثة والحواسيب العملاقة العلمية غالبًا ما تواجه قيودًا على نقل البيانات والطاقة قبل استنفاد قدرتها الحسابية الخام. ولا يُفيد مُحرك المصفوفات الأسرع إلا إذا تمكنت أوزان النموذج والتنشيطات والنتائج الوسيطة من الوصول إليه بسرعة كافية. وبالمثل، لا تُفيد إضافة المزيد من المُسرّعات إلا إذا كانت الحزمة وشبكة الرفوف ونظام الذاكرة ونظام التبريد ومجموعة البرامج قادرة على إبقائها مشغولة.
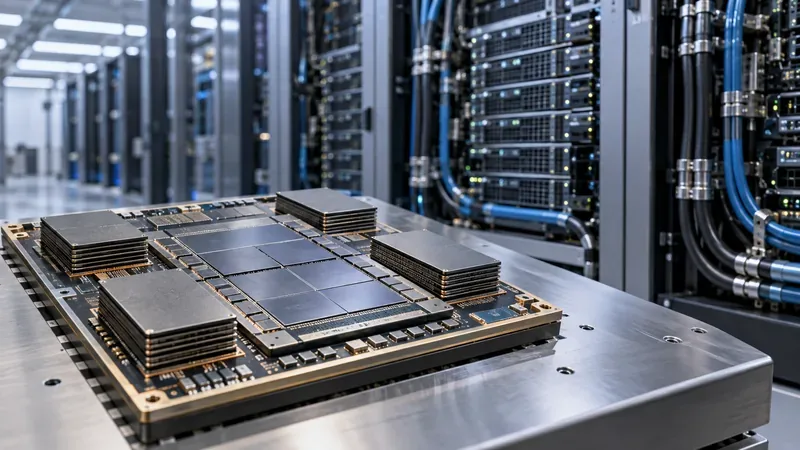
تتجاوز تقنيات المنطق المتطورة بنية FinFET التي هيمنت على الرقائق المتقدمة لسنوات. تعتمد تصميمات GAA (البوابة المحيطة بالكامل) على لف البوابة حول صفيحة نانوية أو بنية قناة مماثلة، مما يمنح مصممي الرقائق تحكمًا كهروستاتيكيًا أدق مع تصغير المكونات. يمكن لهذا أن يحسن الأداء، ويقلل التسريب، أو يوفر توازنًا أفضل بينهما.
أعلنت شركة TSMC أن عملية تصنيعها N2 بتقنية 2 نانومتر دخلت مرحلة الإنتاج الكمي في الربع الأخير من عام 2025، بينما تجمع تقنية A16 بين ترانزستورات النانو شيت وقضيب طاقة خلفي، وهي مصممة خصيصًا لمنتجات الحوسبة عالية الأداء التي تتطلب كثافة عالية في توصيل الطاقة. وقد صرحت TSMC أن الإنتاج الكمي لتقنية A16 مُقرر في النصف الثاني من عام 2026. للمزيد من المعلومات، يُرجى الاطلاع على صفحة تقنية A16 والتقرير السنوي لعام 2025 الخاص بالشركة .
تتبع إنتل نهجًا مشابهًا مع معالج Intel 18A. تجمع هذه التقنية بين ترانزستورات RibbonFET GAA وتقنية PowerVia لتوصيل الطاقة من الجهة الخلفية. أفادت إنتل أن معالج 18A دخل مرحلة الإنتاج في عام 2025، بينما دخل الإصدار المحسن 18A-P مرحلة الإنتاج التجريبي في يونيو 2026. كما تنشر إنتل بيانات مقارنة حول الأداء واستهلاك الطاقة وكثافة الطاقة لهذه التقنية؛ وهذه الأرقام مُقدمة من الشركة المصنعة، ويجب التحقق منها بناءً على تصميم محدد، وليس اعتبارها تحسينات عامة على مستوى الشريحة. تتوفر التفاصيل الحالية على صفحة معالج Intel 18A .
يُعدّ توفير الطاقة من الجهة الخلفية أمرًا بالغ الأهمية، إذ يتعين على الرقائق المتقدمة توجيه كلٍّ من الإشارات والطاقة عبر أسلاك كثيفة للغاية. ويمكن لنقل جزء من شبكة توصيل الطاقة إلى الجهة الخلفية أن يُحرّر موارد التوجيه على جانب الإشارة ويُحسّن توصيل الجهد. بالنسبة لمسرّعات الذكاء الاصطناعي، حيث تُبدّل مجموعات كبيرة من وحدات الحوسبة بمعدلات عالية، قد يكون ذلك بنفس أهمية كثافة الترانزستورات.
تصبح الرقاقات المتكاملة أكثر صعوبة وتكلفة في التوسع مع نموها. توفر الرقاقات الصغيرة مسارًا آخر: حيث يمكن تصنيع وظائف منفصلة بتقنيات معالجة تناسبها على أفضل وجه، ثم ربطها داخل حزمة واحدة. قد تحتاج رقاقة الحوسبة إلى أحدث تقنيات المعالجة المنطقية، بينما قد لا تحتاج إليها وحدات الإدخال/الإخراج، أو ذاكرة التخزين المؤقت، أو الدوائر التناظرية، أو غيرها من الوظائف.
التغليف هو ما يجعل هذا الأمر عمليًا. على سبيل المثال، صُممت منصة التغليف المتقدمة CoWoS من TSMC لدمج العديد من الأجهزة المنطقية ومجموعات من ذاكرة النطاق الترددي العالي في حزمة ثنائية الأبعاد ونصف. وتُركز TSMC بشكل خاص على منصة CoWoS لمنتجات الذكاء الاصطناعي والحوسبة عالية الأداء، حيث تُعد الوصلات القصيرة والواسعة بين الحوسبة وذاكرة النطاق الترددي العالي أمرًا بالغ الأهمية.
تظهر معايير جديدة لجعل الرقاقات الصغيرة أقل احتكارًا. يدعم معيار UCIe 3.0 ، الذي صدر في أغسطس 2025، معدلات نقل بيانات تبلغ 48 جيجابت/ثانية و64 جيجابت/ثانية، ويضيف ميزات لتحسين كفاءة الطاقة، وسهولة الإدارة، وأنظمة متعددة الرقاقات أكثر مرونة. لا يجعل UCIe الرقاقات الصغيرة قابلة للتبديل بين عشية وضحاها، ولكنه يوفر للصناعة إطارًا كهربائيًا وبروتوكوليًا مشتركًا للوصلات داخل الرقاقة.
يُعدّ هذا النهج جذابًا للغاية عندما ترغب شركة ما في بناء عدة أنواع من المعالجات المسرّعة باستخدام وحدات بناء قابلة لإعادة الاستخدام. لكنه يصبح أقل جاذبية عندما تتجاوز تكلفة التغليف أو الكثافة الحرارية أو تعقيد التصميم ميزة التصميم المعياري. قد يكون من الأنسب لمنتج أصغر حجمًا ذي احتياجات متواضعة من الذاكرة ووحدات الإدخال/الإخراج استخدام جهاز متكامل أبسط.
تُنقل أحمال عمل الذكاء الاصطناعي بشكل متكرر موترات كبيرة بين وحدات الذاكرة والحساب. وهذا يجعل عرض نطاق الذاكرة قيدًا أساسيًا في التصميم. تعالج ذاكرة النطاق الترددي العالي (HBM) هذه المشكلة من خلال تكديس رقائق DRAM ووضعها بالقرب من المُسرِّع عبر واجهة عريضة جدًا.
تنتقل تقنية HBM4 الآن من مرحلة التخطيط إلى مرحلة الإنتاج التجاري. أعلنت سامسونج عن بدء شحنات HBM4 التجارية في فبراير 2026، وأوضحت أن منتجها دخل مرحلة الإنتاج الضخم بمعدل نقل بيانات مستدام يبلغ 11.7 جيجابت/ثانية، مع إمكانية رفعه إلى 13 جيجابت/ثانية. وفي مايو 2026، أعلنت سامسونج أيضًا عن شحن عينات من HBM4E. تتوفر هذه التفاصيل في إعلان سامسونج عن إنتاج HBM4 .
أعلنت شركة إس كيه هاينكس في نتائجها للربع الثاني من عام 2026 أنها بدأت شحن كميات كبيرة من ذاكرة HBM4 خلال الربع، وتخطط لزيادة الإنتاج في النصف الثاني من العام. كما شحنت الشركة عينات من ذاكرة HBM4E ذات 12 طبقة. للاطلاع على الوضع الحالي، يُرجى مراجعة نتائج إس كيه هاينكس للربع الثاني من عام 2026 .
لماذا يُعدّ هذا الأمر مهمًا عمليًا؟ تُشير مواصفات NVIDIA Vera Rubin الحالية إلى سعة 288 جيجابايت من ذاكرة HBM4 على وحدة معالجة رسومية واحدة من طراز Rubin، وعرض نطاق ترددي لذاكرة وحدة معالجة الرسوميات يبلغ 19.2 تيرابايت/ثانية. في المقابل، تستخدم مُسرّعات سلسلة MI350 من AMD ذاكرة HBM3E؛ حيث تُشير AMD إلى سعة تصل إلى 288 جيجابايت وعرض نطاق ترددي يصل إلى 8 تيرابايت/ثانية لوحدة MI355X. هذه بنى مختلفة، ولا ينبغي مقارنتها بناءً على رقم عرض النطاق الترددي فقط، ولكن كلاهما يُوضّح كيف أصبحت سعة الذاكرة وعرض النطاق الترددي من المواصفات الأساسية للمُسرّعات، وليست تفاصيل ثانوية. راجع المواصفات الرسمية لـ NVIDIA Vera Rubin NVL72 وصفحة سلسلة AMD Instinct MI350 .
نادراً ما تتسع النماذج الكبيرة والمحاكاة العلمية لجهاز واحد. لذا، يتعين على النظام توزيع العمل على عدة معالجات تسريع وتبادل النتائج الجزئية بشكل متكرر. وإذا كان الاتصال بطيئاً، فإن وحدات الحوسبة باهظة الثمن ستبقى خاملة.
لهذا السبب، تتطور تقنيات توسيع النطاق الخاصة بالشركات جنبًا إلى جنب مع وحدات معالجة الرسومات نفسها. تستخدم منصة Rubin من NVIDIA الجيل السادس من NVLink؛ حيث تُعلن NVIDIA عن عرض نطاق ترددي NVLink يبلغ 3 تيرابايت/ثانية لكل وحدة معالجة رسومات Rubin، و216 تيرابايت/ثانية عبر نظام NVL72. تستخدم AMD تقنية Infinity Fabric في منصات التسريع الخاصة بها. بالنسبة للمشترين، لا يقتصر السؤال المهم على ذروة عرض النطاق الترددي للرابط فحسب، بل يشمل أيضًا كيفية أداء هذه التقنية في ظل العمليات الجماعية الدقيقة، وأنماط التوازي النموذجي، والبنية المستخدمة من قِبل التطبيق.
على مستوى ذاكرة النظام، يتطور بروتوكول Compute Express Link أيضًا. ويشير اتحاد CXL إلى أن الإصدار 4.0 من CXL يضاعف سرعة الإشارة من 64 جيجابت/ثانية إلى 128 جيجابت/ثانية، ويضيف منافذ مجمعة، ويعزز ميزات موثوقية الذاكرة. يُعد CXL خيارًا مناسبًا عندما يرغب المصممون في توسيع الذاكرة أو تجميعها أو فصلها بشكل متناسق دون التعامل مع كل طبقة ذاكرة كوحدة تخزين منفصلة.
لا يزال النحاس خيارًا ممتازًا للوصلات الكهربائية القصيرة والكثيفة، لكن الوصلات الضوئية تزداد جاذبية مع ازدياد المسافة وعرض النطاق الترددي الإجمالي. وتتمثل الخطوة الرئيسية التالية في دمج المكونات الضوئية معًا، حيث تُنقل هذه المكونات إلى مكان أقرب من شريحة ASIC الخاصة بالشبكات، بدلًا من وجودها بالكامل في أجهزة الإرسال والاستقبال القابلة للتوصيل على حافة المحول.
تُشير NVIDIA إلى أن منصة Spectrum-X Ethernet Photonics الخاصة بها تستخدم بصريات مُدمجة، وتُحقق كفاءة طاقة شبكية أفضل بخمس مرات من تصميمات أجهزة الإرسال والاستقبال التقليدية القابلة للتوصيل. هذه مقارنة بين مُصنّعين مُختلفين، وليست ضمانًا لجميع بنى مراكز البيانات، لكنها تُسلط الضوء على التوجه السائد: فقد أصبحت طاقة الشبكة عاملًا بالغ الأهمية لدرجة أن التكامل البصري بات جزءًا لا يتجزأ من تصميم أنظمة أشباه الموصلات. راجع نظرة NVIDIA العامة على تقنية الفوتونات السيليكونية .
| عبء العمل | ميزات أشباه الموصلات التي يجب إعطاؤها الأولوية | لماذا هم مهمون؟ |
|---|---|---|
| التدريب المسبق للنماذج الكبيرة | سعة ونطاق ترددي عاليان لذاكرة النطاق الترددي، وصلات توسيع سريعة، تغليف كثيف، تبريد قوي | يركز التدريب بشكل كبير على حركة الموتر والتواصل المتزامن عبر العديد من المسرعات. |
| الاستدلال طويل السياق والفاعلية | مجموعات HBM كبيرة، وحوسبة فعالة منخفضة الدقة، وعرض نطاق ربط عالي، وتقسيم الذاكرة إلى طبقات | يمكن أن تجعل ذاكرة التخزين المؤقت KV وخطوات الاستدلال المتكررة سعة الذاكرة ونقل البيانات أكثر تقييدًا من ذروة عمليات FLOPS. |
| الحوسبة عالية الأداء العلمية | إمكانية استخدام FP64، ونطاق ترددي للذاكرة، ووصلات بينية موثوقة، ومكتبات رقمية متطورة | تعتمد رموز المحاكاة غالبًا على الدقة المزدوجة وعرض النطاق الترددي المستدام بدلاً من معدل نقل الموتر منخفض الدقة فقط. |
| الاستدلال المؤسسي | الأداء لكل واط، توافق البرامج، ذاكرة ذات حجم مناسب، خيارات نشر PCIe | قد يكون النظام الأفضل هو النظام الذي يتناسب مع الخوادم الحالية ومستويات الطاقة بدلاً من بنية الرفوف ذات الكثافة الأعلى. |
| مسرعات مخصصة | استراتيجية الرقائق الصغيرة، ونظام التغليف البيئي، ودعم UCIe، ونضج العملية | يمكن أن تؤدي الوحدات النمطية إلى تقصير دورات إعادة الاستخدام، ولكن تعقيد التغليف وتأهيل سلسلة التوريد يمكن أن يعوض الفائدة. |
لنفترض فريقًا يُشغّل نموذجًا لغويًا ضخمًا بنوافذ سياقية طويلة. ولنفترض أن التحليل يُظهر أن وحدات معالجة الرسومات (GPUs) تنتظر بشكل متكرر عمليات نقل البيانات في الذاكرة والتواصل بينها. قد يُساعد الانتقال إلى مُسرّع أحدث، ولكن فقط إذا كان النظام الجديد يُوفّر سعة كافية لذاكرة HBM، ونطاق ترددي أسرع للذاكرة، وبنية تُقلّل من حالات توقف الاتصال. قد لا يُحقق شراء جهاز ذي أداء نظري أعلى في التعامل مع الموترات، مع الإبقاء على نفس اختناقات الذاكرة والشبكة، تحسينًا يُذكر مقارنةً بالمواصفات المعلنة.
يظهر المبدأ نفسه في الحوسبة الفائقة التقليدية. يجمع نظام Frontier التابع لمختبر أوك ريدج الوطني بين مُسرّعات AMD MI250X وذاكرة HBM ونظام ربط عالي السرعة. يوثّق دليل مستخدم Frontier كيفية عمل الحوسبة وذاكرة HBM وروابط وحدة المعالجة المركزية ووحدة معالجة الرسومات وشبكة Slingshot معًا. صحيح أن جيل الأجهزة أقدم من أحدث منصات الذكاء الاصطناعي لعام 2026، إلا أن الدرس المعماري لا يزال ساريًا: يعتمد الأداء المستدام للتطبيقات على المسار بين الحوسبة والذاكرة والعُقد الأخرى.
تكون الترقية أكثر جدوى عندما تعالج مشكلة محددة بدلاً من مجرد استبدال رقم قطعة قديم. قبل الالتزام بجيل جديد من المعالجات، تحقق مما يلي:
يُحقق التقدم في مجال أشباه الموصلات قدراتٍ مذهلة، لكن العوامل المُقيِّدة باتت أكثر وضوحًا. فالحزم المتقدمة أكبر حجمًا وأكثر تعقيدًا في التصنيع. وتُركِّز رُزم ذاكرة النطاق العالي الحرارة بالقرب من الدوائر المنطقية عالية الطاقة. وقد تتطلب الأنظمة المُدمجة في الرفوف تبريدًا سائلًا، وتوزيعًا كثيفًا للطاقة، وشبكات مُتخصصة. يُمكن للبصريات المُدمجة في حزمة واحدة أن تُقلِّل من استهلاك الطاقة في الشبكات، لكنها تُضيف اعتبارات جديدة في التصنيع والصيانة. يُمكن للرقاقات الصغيرة أن تُحسِّن من قابلية التعديل، لكنها تُضيف أعمال التحقق والتغليف وإدارة الإنتاجية.
هناك أيضًا مفاضلة برمجية. فالحسابات منخفضة الدقة، مثل FP8 وFP6 وFP4، تُحسّن بشكل كبير من إنتاجية الذكاء الاصطناعي، لكن يجب على البرمجيات الحفاظ على جودة النموذج. وقد لا تتمكن البرامج العلمية من استخدام نفس الاختصارات. ولا تُعدّ ميزة أشباه الموصلات قيّمة إلا عندما تستطيع حزمة التطبيقات استغلالها دون الإخلال بمتطلبات الدقة أو الموثوقية.
خلال الفترة المتبقية من عام 2026 وحتى عام 2027، لن تقتصر المؤشرات الأكثر أهمية على أسماء العقد الجديدة فحسب. راقبوا ما إذا كانت معالجات TSMC A16 ومعالجات Intel من عائلة 18A ستُستخدم على نطاق واسع في منتجات العملاء؛ ومدى سرعة توفر ذاكرات HBM4 وHBM4E على نطاق واسع؛ وما إذا كان معيار UCIe 3.0 يُحقق توافقًا فعالًا بين رقائق متعددة الموردين؛ وأين سيظهر معيار CXL 4.0 في أنظمة الإنتاج؛ وما إذا كانت البصريات المدمجة في حزمة واحدة تُثبت جدواها الاقتصادية وكفاءتها على نطاق واسع.
ستوضح هذه المعالم ما إذا كان بإمكان صناعة أشباه الموصلات مواصلة تطوير الذكاء الاصطناعي والحوسبة الفائقة دون السماح لنقل الذاكرة وتوصيل الطاقة والشبكات والتبريد باستهلاك المكاسب التي تحققت من خلال المنطق الأكثر كثافة.
يعتمد مستقبل الذكاء الاصطناعي والحوسبة الفائقة بشكل أقل على "العقدة التالية" الواحدة، وأكثر على هندسة أشباه الموصلات المنسقة. تعمل ترانزستورات GAA والطاقة الخلفية على تحسين البنية المنطقية. تتيح الرقاقات الصغيرة والتغليف المتقدم للمصممين تجميع أنظمة أكبر مما يمكن أن توفره رقاقة واحدة بسهولة. تغذي ذاكرة HBM4 المسرعات بنطاق ترددي فائق. تنقل تقنيات UCIe وCXL وNVLink وInfinity Fabric والشبكات الضوئية البيانات عبر نطاقات أكبر بشكل متزايد.
عند اختيار الأجهزة، ابدأ بتحديد نقطة الضعف الحقيقية في عبء العمل. بالنسبة للذكاء الاصطناعي الذي يعتمد بشكل كبير على الذاكرة، أعطِ الأولوية لسعة ذاكرة HBM وعرض النطاق الترددي. أما بالنسبة للتدريب الموزع، فأعطِ الأولوية لبنية التوسع الرأسي والأفقي. بالنسبة للحوسبة العلمية، تحقق من أداء FP64 والمكتبات. بالنسبة للنشر المؤسسي، ضع في اعتبارك استهلاك الطاقة والتبريد ودعم البرامج وجهد التكامل عند اتخاذ القرار. إن أسرع أشباه الموصلات نظريًا ليس بالضرورة النظام الأسرع أو الأكثر اقتصادية لعبء العمل لديك.
قارن بين مركز برامج Pardus وأوامر APT للعثور على الحزم وتثبيتها وإزالتها وتحديثها باستخدام الطريقة التي تناسب مهمتك.
انظر ماذا تعني متطلبات ذاكرة الوصول العشوائي المنشورة من Pardus، ثم قارن بين XFCE و GNOME على نفس جهاز الكمبيوتر مع قراءات MemAvailable قابلة للتكرار.
تعرف على مكانة HamoniKR 8.0 في خطة سطح المكتب للأعمال، وما هي الميزات التي تدعمها والتي تركز على اللغة الكورية، وما يجب التحقق منه قبل طرحها على نطاق أوسع.
افهم كيف تتكامل عملية التحقق من بدء التشغيل وحماية وقت التشغيل في Gooroom، وماذا تعني "البيئة المعزولة"، وما هي الإعدادات التي يجب عليك التحقق منها على جهازك.
قارن متطلبات HamoniKR 8.0 LTS و Lite، ثم اختبر Wi-Fi والرسومات وعناصر التحكم في الكمبيوتر المحمول من USB مباشر قبل التثبيت.
قارن بين تثبيتات Ubuntu Server 24.04 المصغرة والقياسية من حيث ذاكرة الوصول العشوائي ومساحة القرص ووقت بدء التشغيل ووحدة المعالجة المركزية وأحمال العمل الحقيقية - دون ادعاءات مضللة بشأن المعايير.
قم ببناء خطة عملية لاستمرارية العمل في حالة توقف Salesforce مع أولويات واضحة، وسير عمل احتياطي، وفحوصات استعادة، ومعايير اختبار، وحدود واقعية.
قد تُؤدي مشاكل نظام StoreForce إلى تعطيل الجداول الزمنية، وتسجيل ساعات العمل، وتغييرات الورديات، والتواصل داخل المتجر. تعرّف على كيفية تشخيص المشكلة، والحفاظ على سير عمليات البيع بالتجزئة بسلاسة، والتحقق من استعادة النظام.
تعرف على كيفية الاتصال بدعم Salesforce أثناء انقطاع كبير للخدمة، واختيار القناة المناسبة، وإعداد حالة مفيدة، والمتابعة دون إنشاء تذاكر مكررة.
قم باستكشاف أخطاء Salesforce Workbench وإصلاحها أثناء فترة التوقف عن طريق التحقق من حالة الثقة، وتصنيف رموز API، وحماية البيانات، والتحقق من الاسترداد.