الرئيسية
» تكنولوجيا
»
ما الذي يُسبب انقطاع الخدمة على نطاق واسع في منصات الحوسبة السحابية؟ أنماط الأعطال الكامنة وراء حالات الانقطاع الرئيسية
ما الذي يُسبب انقطاع الخدمة على نطاق واسع في منصات الحوسبة السحابية؟ أنماط الأعطال الكامنة وراء حالات الانقطاع الرئيسية
نادراً ما ينتج توقف منصة الحوسبة السحابية على نطاق واسع عن تعطل خادم واحد ببساطة. عادةً ما تبدأ الحوادث الأكثر تعطيلاً بعطل فني واحد - تكوين سيئ، أو خلل في البرامج، أو مشكلة في نظام أسماء النطاقات، أو فشل في الشبكة، أو حدث في البنية التحتية - ثم تنتشر لأن العديد من الخدمات تعتمد على نفس مستويات التحكم، وقواعد البيانات، وأنظمة الهوية، وموازنات الأحمال، أو الموارد الإقليمية.
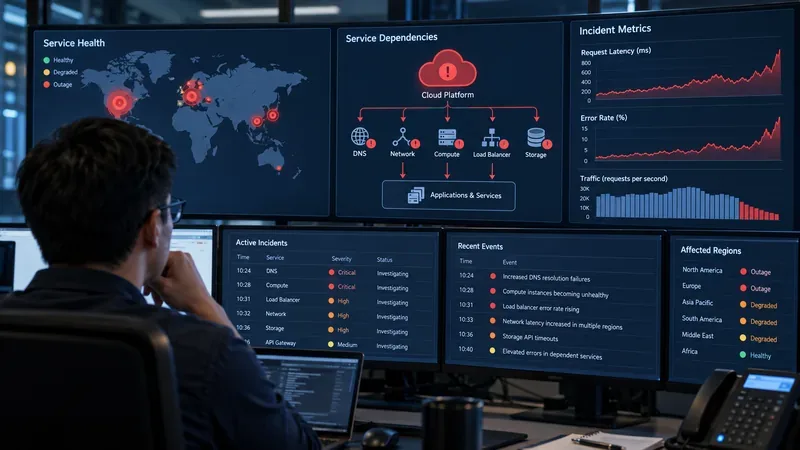
سيناريو توضيحي: تخيل مزود خدمة سحابية وهمي يُدعى نورث ستار كلاود. في تمام الساعة 10:05 صباحًا، تم تطبيق تغيير تلقائي على الشبكة لخدمة إقليمية. في غضون دقائق، بدأ العملاء بالإبلاغ عن فشل استدعاءات واجهة برمجة التطبيقات (API). في الساعة 10:12، توقف تشغيل الأجهزة الافتراضية الجديدة. في الساعة 10:20، بدأت موازنات الأحمال في تصنيف الخوادم الخلفية السليمة على أنها غير متاحة. بحلول الساعة 10:35، تدهورت حالة عشرات المنتجات التي تبدو غير ذات صلة. هذا السيناريو افتراضي، وليس وصفًا لانقطاع حقيقي. تكمن فائدته في أنه يوضح كيف يمكن لعطل بسيط أن يتحول إلى حدث كبير على مستوى النظام.
غالباً ما تحتاج فرق عمليات الحوسبة السحابية إلى تتبع الانقطاع من أول تبعية فاشلة مروراً بنظام أسماء النطاقات (DNS) والشبكات والحوسبة وموازنة الأحمال والتخزين والتطبيقات النهائية.
باختصار: عادةً ما تكون حالات انقطاع الخدمة السحابية الرئيسية عبارة عن سلسلة من الأعطال المتتالية
تتمثل الأسباب الرئيسية وراء انقطاع الخدمة على نطاق واسع في منصات الحوسبة السحابية في أخطاء التكوين والنشر، وعيوب البرمجيات الكامنة، وأعطال نظام أسماء النطاقات (DNS) والتوجيه، واعتماد الخدمات المشتركة، ونفاد السعة أثناء العطل أو الاستعادة، ومشاكل مستوى التحكم، والأعطال المادية التي تؤثر على مركز البيانات أو منطقة التوافر. ويعتمد حجم الانقطاع بشكل أقل على الخطأ الأول، وأكثر على مدى انتشار مشاركة المكون المتأثر.
يُعدّ مثال AWS مثالًا عمليًا مفيدًا. ففي ملخصها الرسمي لما بعد انقطاع الخدمة في أكتوبر 2025 في شمال فرجينيا، ذكرت AWS أن حالة تضارب كامنة في نظام إدارة DNS الآلي لـ DynamoDB أنتجت سجل DNS فارغًا غير صحيح لنقطة النهاية الإقليمية. وقد أثّر هذا العطل في نظام DNS على العملاء وخدمات AWS الداخلية التي تعتمد على DynamoDB، وساهمت جهود الاستعادة اللاحقة في مشاكل تتعلق بتشغيل EC2 وموازنات تحميل الشبكة. وقد تم توثيق هذا الحادث في ملخص AWS لما بعد انقطاع خدمة DynamoDB في أكتوبر 2025 .
1. قد تؤدي تغييرات التكوين إلى إنشاء نصف قطر انفجار كبير بشكل غير متوقع
تُعدّ أخطاء التكوين من أكثر الأنماط شيوعًا في حوادث الأنظمة الموزعة الكبيرة، نظرًا لأن المنصات الحديثة تُدار آليًا. إذ يُمكن تطبيق تغيير واحد على آلاف الأجهزة المضيفة، والموجهات، وسجلات نظام أسماء النطاقات، أو نقاط نهاية الخدمة، بسرعة تفوق قدرة المشغل البشري على تعديلها يدويًا.
بالعودة إلى سيناريو Northstar Cloud، لنفترض أن تغيير الشبكة الذي طرأ في الساعة 10:05 كان مُخصصًا لعشرة أجهزة، ولكنه طُبِّق على عدة مناطق. لا يُشترط أن يُؤدي هذا التغيير إلى تلف الأجهزة، بل قد يُقلل ببساطة من سعة الشبكة المُتاحة، أو يُغير مسارات التوجيه، أو يتسبب في رفض الأنظمة لحركة البيانات السليمة. بمجرد أن تنخفض السعة المُشتركة عن الطلب، يُواجه العملاء حالات انقطاع الاتصال وإعادة المحاولة، مما يُؤدي إلى زيادة الضغط على الشبكة.
وصفت جوجل آلية مشابهة في تقريرها الرسمي عن انقطاع الخدمة عام ٢٠١٩: حيث طُبِّق تغيير في الإعدادات، كان مُخصَّصًا لعدد محدود من الخوادم في منطقة واحدة، بشكل خاطئ على نطاق أوسع بكثير، مما تسبب في توقف مناطق متعددة عن استخدام أكثر من نصف سعة الشبكة المتاحة. ثم أدى ذلك إلى ازدحام الشبكة على السعة المتبقية. راجع التحديث الرسمي لجوجل حول انقطاع الخدمة عام ٢٠١٩ .
لهذا السبب، يستخدم مشغلو الحوسبة السحابية المتمرسون عمليات نشر تدريجية، والتحقق من صحة البيانات، والتراجع التلقائي، وحدود معدل التغيير، وضوابط "نطاق التأثير". لا تقضي هذه الضمانات على الحوادث تمامًا، ولكنها تمنع تحول تغيير واحد سيئ إلى كارثة شاملة للمنصة.
2. قد تبقى عيوب البرمجيات مخفية حتى تحدث ظروف توقيت نادرة
تدير منصات الحوسبة السحابية الكبيرة أساطيل هائلة من البرامج الموزعة. وتبقى بعض العيوب كامنة لأشهر أو سنوات لأنها تتطلب تسلسلًا نادرًا من الأحداث: قيام وحدتي تحكم بتحديث الحالة نفسها، أو حدوث تأخير غير معتاد، أو وجود بيانات وصفية قديمة، أو تشغيل عملية استرداد في الوقت نفسه مع عملية تنظيف.
في حادثة نورث ستار الخيالية، تخيل أن عاملين آليين مستقلين يقومان بتحديث نفس خطة نظام أسماء النطاقات (DNS). يتأخر أحدهما، بينما يُكمل الآخر تحديثًا أحدث، ثم تقوم عملية تنظيف بإزالة البيانات التي فعّلها العامل المتأخر للتو. قد يبدو كل مكون على حدة وكأنه يعمل كما هو مصمم، لكن تفاعلهما يُنشئ حالة غير صالحة.
يُجسّد حدث AWS DynamoDB لعام 2025 هذه الفئة بوضوح. فقد عزت AWS فشل بدء التشغيل إلى حالة تنافس كامنة بين مكونات إدارة نظام أسماء النطاقات (DNS) المتكررة. ولا تقتصر أهمية هذا الأمر على مُورّد واحد، إذ لا يُحسّن التكرار الموثوقية إلا عندما لا تستطيع المكونات المتكررة إتلاف الحالة المشتركة من خلال نفس المنطق أو فشل التزامن.
3. قد تؤدي أعطال نظام أسماء النطاقات (DNS) والشبكات إلى جعل الأنظمة السليمة غير قابلة للوصول
قد تكون الخدمة قيد التشغيل بالكامل، ومع ذلك تظل غير متاحة فعليًا إذا لم يتمكن العملاء من الوصول إلى اسم المضيف الخاص بها أو إذا لم تصل إليها الحزم. ولذلك، تُعدّ أنظمة أسماء النطاقات (DNS) والتوجيه وموازنة الأحمال وتكوين الشبكة عناصر أساسية في المسار الحرج لجميع منتجات الحوسبة السحابية تقريبًا.
في مثال نورث ستار، قد يفترض العملاء أن خدمة الحوسبة نفسها قد تعطلت بسبب انتهاء مهلة استدعاءات واجهة برمجة التطبيقات (API). ولكن قد تكون خوادم الحوسبة الفعلية سليمة، بينما لا يُرجع نظام أسماء النطاقات (DNS) أي نقطة نهاية قابلة للاستخدام، أو أن مسارًا مفقود، أو أن موازن الأحمال قد أزال أهدافًا سليمة.
وثّقت AWS هذا النمط من الأعطال أكثر من مرة. ففي حادثة وقعت في منطقة سيول عام 2018، ذكرت AWS أن تحديثًا للإعدادات أدى إلى إزالة إعدادٍ يُحدد الحد الأدنى لعدد المضيفين السليمين لأسطول مُحلِّل أسماء النطاقات (DNS) الخاص بـ EC2. وتسبب انخفاض سعة المُحلِّل في فشل استعلامات DNS من مثيلات EC2. ويمكن الاطلاع على التفاصيل في ملخص AWS لمشكلة تحليل أسماء النطاقات (DNS) الخاصة بـ EC2 في سيول عام 2018 .
تتفاقم أعطال الشبكة بسرعة أيضاً لأن التطبيقات تعيد محاولة الاتصال الفاشل. وقد يؤدي سلوك إعادة المحاولة المفرط إلى تحويل خلل جزئي في الشبكة إلى زيادة كبيرة في حركة البيانات.
4. تؤدي التبعيات المشتركة إلى فشل الخدمات غير ذات الصلة معًا
لا تُعدّ الخدمات السحابية منتجات معزولة. فقد تعتمد قاعدة البيانات المُدارة على خدمات الهوية، ونظام أسماء النطاقات الداخلي، والتخزين، والشبكات، وأنظمة الجدولة، وخدمات الشهادات، وبيانات القياس عن بُعد. كما قد تعتمد المنصة غير الخادمة على سعة الحوسبة، والشبكات، وأنظمة إدارة قوائم الانتظار، وقواعد بيانات مستوى التحكم. وفي حال تعطل أحد هذه المكونات المشتركة، قد تتأثر العديد من المنتجات سلبًا في الوقت نفسه.
هذا يفسر أحد أكثر أعراض انقطاع الخدمة إرباكًا: يلاحظ العملاء وجود أخطاء في عدة خدمات، فيفترضون حدوث عدة أعطال مستقلة. في الواقع، قد يكون لجميع الأعطال الظاهرة سبب واحد في المصدر.
في سيناريو نورث ستار، قد تتعطل خدمة الآلة الافتراضية، وخدمة الحاويات، والخدمة غير الخادمية، جميعها لاعتمادها على قاعدة بيانات الموارد الداخلية نفسها. تختلف المنتجات الموجهة للعملاء، لكن التبعية الأساسية بينها واحدة.
أظهر حادث AWS في أكتوبر 2025 هذا النوع من التتالي عندما تأثرت الخدمات الداخلية التي تعتمد على DynamoDB بمشكلة DNS الأصلية، تلتها آثار التعافي اللاحقة عبر EC2، وموازن تحميل الشبكة، وLambda، وخدمات الحاويات، والوظائف المتعلقة بالهوية، وغيرها من المنتجات.
5. قد تفشل عملية الاسترداد لأن حجم العمل المتراكم أكبر من حجم التشغيل العادي
لا يؤدي استعادة المكون المعطل الأصلي دائمًا إلى إنهاء الانقطاع. فخلال فترة التوقف، تتراكم قوائم الانتظار، وتنتهي صلاحية التراخيص، وتفشل فحوصات السلامة، وتطلب أنظمة التوسيع التلقائي سعة بديلة، ويعيد العملاء محاولة الطلبات، وتتراكم تحديثات التكوين. وعندما يعود المكون المعطل، قد تحاول جميع الأنظمة المنتظرة التعافي في آن واحد.
في مثال نورث ستار، لنفترض أن نظام أسماء النطاقات (DNS) قد تم إصلاحه في الساعة 10:45. تحاول آلاف الخوادم الآن تجديد التراخيص المنتهية الصلاحية. في الوقت نفسه، يعيد العملاء محاولة عمليات النشر الفاشلة، وتطلب أنظمة التوسع التلقائي مثيلات بديلة. فجأةً، تعالج لوحة التحكم عدة أضعاف حجم العمل المعتاد. إذا لم تكن لديها حدود فعالة لمعدل الطلبات أو أولوية للاسترداد، فقد تدخل في وضع فشل ثانٍ حتى بعد زوال الخلل الأصلي.
وصفت AWS مشكلة استعادة مماثلة في عام 2025: بعد استعادة الوصول إلى DynamoDB، اضطر نظام فرعي EC2 إلى إعادة إنشاء عدد كبير من عقود الإيجار. أصبح من الصعب معالجة هذا التراكم قبل انتهاء المهلة، وقالت AWS إن النظام الفرعي دخل في حالة "انهيار ازدحامي". هذه التفاصيل مهمة لأنها توضح سبب إمكانية أن تكون مدة الانقطاع أطول بكثير من الوقت اللازم لإصلاح السبب الأولي.
6. قد تؤدي عمليات الفحص الصحي والتحويل التلقائي في حالة الفشل أحيانًا إلى إزالة سعة جيدة
تُعدّ عمليات فحص سلامة الشبكة ضرورية، لكنها في الوقت نفسه تُعتبر أدوات اتخاذ قرارات آلية. فإذا كانت الشبكة بطيئة أو تأخرت عملية نقل البيانات، فقد يستنتج نظام فحص السلامة أن الموارد السليمة معيبة، فيقوم بإخراجها من الخدمة. وهذا بدوره قد يُقلل من سعة الشبكة، مُحدثًا حلقة مفرغة.
في السيناريو الافتراضي، تبدأ موازنات الأحمال في نورث ستار بفحص النسخ المُشغّلة حديثًا قبل اكتمال تطبيق إعدادات الشبكة. تفشل عمليات الفحص، فتُسحب النسخ السليمة، وينتقل تدفق البيانات إلى عدد أقل من العُقد المتبقية، فتُصبح هذه العُقد مُثقلة.
ظهر هذا النمط أيضًا خلال فعالية AWS لعام 2025. أوضحت AWS أن فحوصات سلامة موازن تحميل الشبكة قد تفشل أحيانًا أثناء استمرار تحديث حالة الشبكة للمثيلات الجديدة، مما يؤدي إلى إزالة بعض السعة من الخدمة. وهذا يُذكّر بضرورة تحديد معدل تنفيذ منطق تجاوز الفشل واختباره في ظل حالات الفشل الجزئي، وليس فقط في ظل ظروف "سليمة/غير سليمة" تمامًا.
7. لا تزال أعطال مراكز البيانات والطاقة والتبريد ومناطق التوافر واردة
لا يبدأ كل انقطاع في الخدمة ببرمجيات. فقد تتعطل مصادر الطاقة، وأنظمة التبريد، والألياف الضوئية، وأجهزة الشبكة، وغيرها من البنية التحتية المادية. وقد صُممت بنية الحوسبة السحابية لتراعي هذه الحقيقة، ولذلك يقسم مزودو الخدمة الرئيسيون المناطق إلى مناطق معزولة عن الأعطال.
توضح مايكروسوفت أن مناطق التوافر في Azure عبارة عن مجموعات منفصلة من مراكز البيانات ذات مصادر طاقة وتبريد وشبكات مستقلة. كما تشير مايكروسوفت إلى أن نشر المناطق لا يضمن استمرار الخدمة تلقائيًا في حال انقطاع الخدمة في منطقة معينة؛ إذ يجب على العملاء استخدام مناطق متعددة أو خدمات ذات تكرار في المناطق حيثما كان ذلك مدعومًا. راجع نظرة عامة مايكروسوفت الرسمية على مناطق التوافر في Azure .
من الناحية العملية، يمكن لمزود الخدمة السحابية أن يجعل المنطقة مستقلة، ولكن قد يظل عبء عمل العميل يحتوي على قاعدة بيانات منطقة واحدة، أو تبعية تحكم إقليمية واحدة، أو عملية تجاوز الفشل التي لم يتم تنفيذها مطلقًا.
لماذا قد يبدو انقطاع الخدمة السحابية عالميًا حتى عندما يكون السبب الجذري إقليميًا؟
غالبًا ما يُستخدم مصطلح "انقطاع الخدمة العالمي" لوصف مدى تأثيره على العملاء، وليس الموقع الفعلي للمعدات المعطلة. قد تدعم خدمة إقليمية المصادقة، ونظام أسماء النطاقات (DNS)، والبيانات الوصفية، ومسارات البناء، ولوحات المعلومات، أو واجهات برمجة التطبيقات (APIs) المستخدمة من مناطق أخرى. وبالتالي، قد تتعطل التطبيقات في جميع أنحاء العالم لاعتمادها على خدمة مركزية في موقع واحد.
يُعدّ التمييز بين هذين الأمرين بالغ الأهمية عند تشخيص أي حادث. ينبغي على المهندسين طرح سؤالين مختلفين: أين وقع العطل الأول؟ وما هي العوامل التي سمحت بانتشار هذا العطل؟ غالبًا ما تختلف الإجابات على هذين السؤالين.
كيفية تحديد السبب المحتمل أثناء وقوع حادث مباشر
بالنسبة للمشغلين، عادةً ما يكون المسار الأسرع هو ربط الأعراض ببعضها بدلاً من فحص كل منتج على حدة. إذا تعطلت خدمات متعددة في نفس اللحظة، فابحث عن تبعية مشتركة. إذا ظلت أحمال العمل الحالية سليمة بينما فشلت عمليات النشر الجديدة، فاشتبه في وجود مشكلة في مستوى التحكم أو الجدولة أو السعة أو التزويد. إذا كان اتصال IP يعمل ولكن أسماء الخدمات لا تعمل، فافحص نظام أسماء النطاقات (DNS). إذا ارتفعت معدلات الخطأ بعد إعلان الاسترداد، فابحث عن عواصف إعادة المحاولة، أو تراكم الطلبات، أو انتهاء صلاحية التراخيص، أو حلقات التغذية الراجعة لفحص السلامة، أو عدم كفاية سعة الاسترداد.
يمكن لأنظمة حالة مزودي الخدمة أن تساعد أيضاً في التمييز بين حادثة على مستوى المنصة وعطل خاص بتطبيق معين. فعلى سبيل المثال، تنشر جوجل كلاود الحوادث الحالية والسابقة عبر لوحة معلومات حالة الخدمة الرسمية ، بينما تنشر AWS ملخصات الأحداث الرئيسية عبر ملخصات ما بعد الحدث الرسمية .
ما يمكن للعملاء فعله للحد من التأثير
لا يمكن لأي بنية ضمان انقطاع الخدمة بشكل كامل، ولكن هناك عدة خيارات تصميمية تقلل من المخاطر. استخدم مناطق توافر متعددة لأحمال العمل الإنتاجية عندما تدعمها الخدمة. بالنسبة لأحمال العمل التي لا تتحمل انقطاعًا إقليميًا، قيّم التصاميم متعددة المناطق وافهم المفاضلات المتعلقة باتساق البيانات. تخلص من نقاط الفشل الفردية الخفية، مثل خدمة هوية إقليمية واحدة، أو مسار DNS واحد، أو واجهة برمجة تطبيقات إدارية واحدة تعتمد عليها جميع إجراءات الاسترداد.
ينبغي أن تفشل التطبيقات بسلاسة. قد يشمل ذلك تقديم المحتوى المخزن مؤقتًا، ووضع عمليات الكتابة غير الحرجة في قائمة انتظار، والحد من محاولات إعادة الإرسال باستخدام التراجع الأسي والارتعاش، وفصل عمليات مستوى التحكم عن حركة مرور مستوى البيانات، والحفاظ على وضع "القراءة فقط" أو "المعاملات الأساسية" المخفّض أثناء حالات الانقطاع الجزئي. يجب اختبار إجراءات الاسترداد في ظل ظروف تراكم الطلبات، لأن إعادة تشغيل تبعية في بيئة اختبار فارغة تختلف تمامًا عن استعادتها بينما تنتظر ملايين الطلبات.
الدرس الرئيسي المستفاد من انقطاع الخدمة السحابية على نطاق واسع
بالعودة إلى سيناريو سحابة نورث ستار، قد يكون تغيير الإعدادات في الساعة 10:05 هو السبب الرئيسي، ولكنه ليس التفسير الكامل. يتفاقم الانقطاع بسبب مشاركة الشبكة، ووجود خلل في التوقيت في نظام التشغيل الآلي، واعتماد الخدمات التابعة على نفس الحالة، واستنزاف عمليات فحص السلامة للسعة، وزيادة الحمل نتيجة إعادة المحاولات، وضرورة معالجة أنظمة الاسترداد لكمية هائلة من البيانات المتراكمة.
هذا هو النمط الأساسي وراء العديد من حوادث الحوسبة السحابية الكبرى: غالبًا ما يكون العطل الأولي صغيرًا مقارنةً بسلسلة التبعيات التي تُضخّمه. لذا، فإن فهم تعطل الحوسبة السحابية يعني دراسة كلٍّ من السبب الجذري وانتشاره. وتفترض التصاميم الأكثر مرونة أن المكونات الفردية ستتعطل، وتركز على منع هذه الأعطال من أن تتحول إلى أحداث على مستوى النظام بأكمله.